Какая локальная модель лучше пишет код
Пора переходить к локальным экспериментам!
Что использовать без интернета?
Что использовать без интернета?
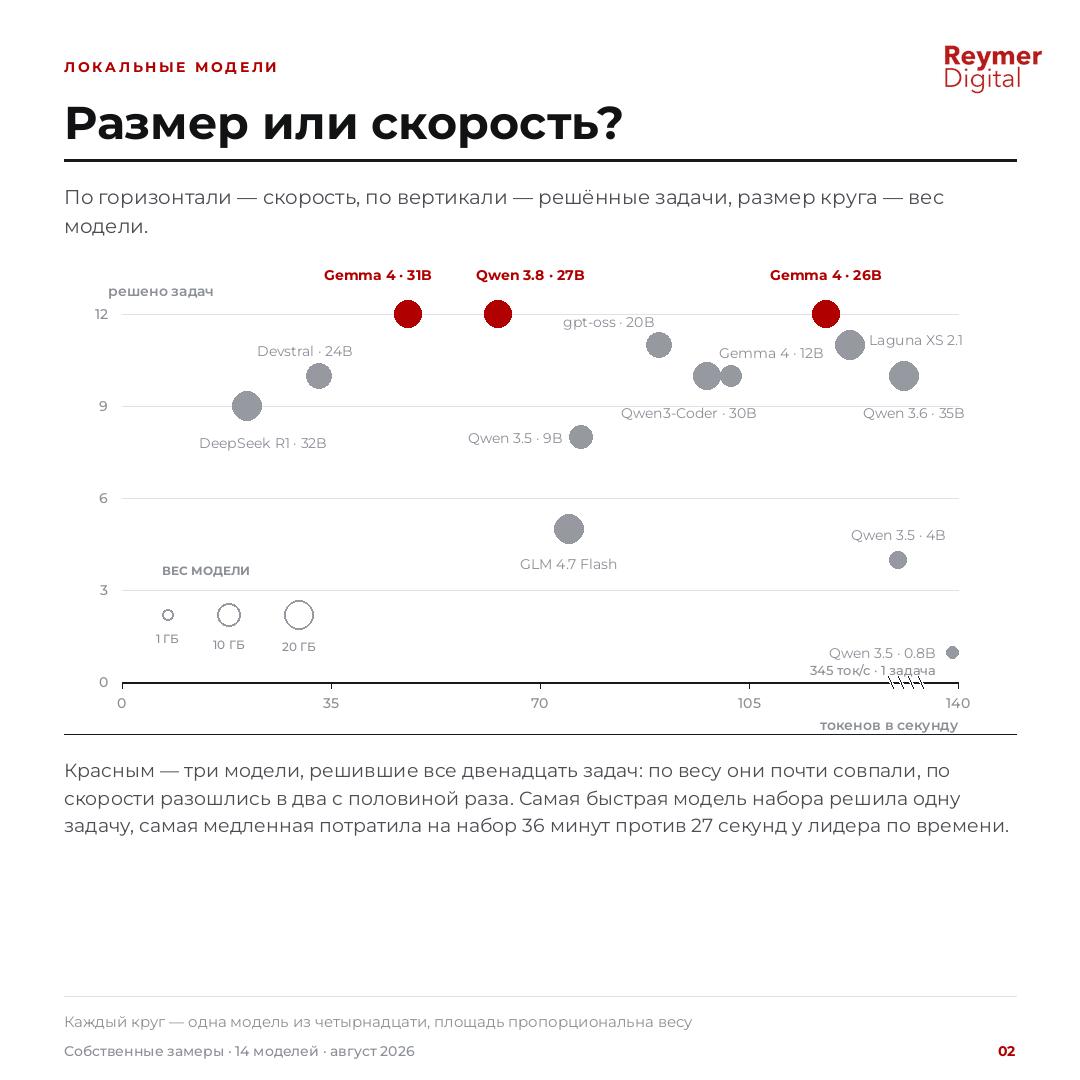
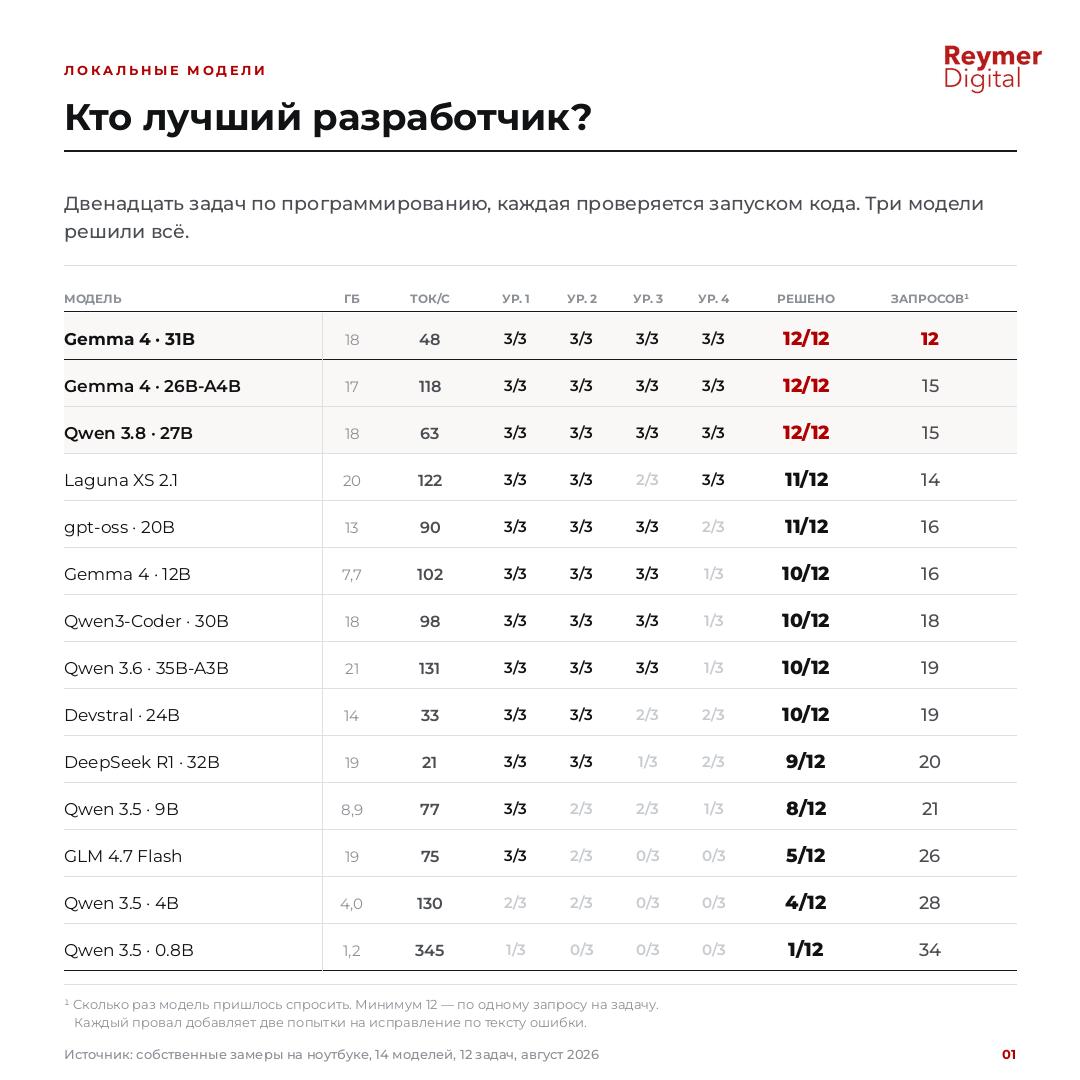
Три модели из четырнадцати написали весь код без ошибок: Gemma 4 31B, Gemma 4 26B, Qwen 3.8 27B. Весят 17-18 ГБ - рабочий ноутбук с 32 ГБ памяти такую держит. Gemma 31B прошла набор с первой попытки на каждой задаче.
Вопрос встаёт там, где код и данные не должны покидать периметр: закрытый контур, чужой NDA, персональные данные. Проверка - 12 задач на Python, от частоты слов до LFU-кэша и вычислителя выражений (тесты готовил Fable). Ответ модели запускается на тестах; не прошёл - модель получает текст ошибки и ещё две попытки.
"Я печатаю со скоростью 1000 слов минуту! Но такая ерунда получается". Самая быстрая модель набора, 345 токенов в секунду, решила одну задачу из двенадцати. Gemma 12B весом 7,7 ГБ решила десять, GLM 4.7 Flash весом 19 ГБ - пять. Размер отсекает только мелочь: до 4 ГБ не решается почти ничего, выше закономерность пропадает.
Скорость упирается в память. Чтобы выдать токен, модель прочитывает свои веса целиком, вычислитель простаивает. Потолок - полоса памяти, делённая на объём чтения. Плотные модели легли под кривую с КПД 73-93%; выше неё те, кто меняет знаменатель в архитектуре модели: MoE читает часть весов, MTP выдаёт несколько токенов за чтение.
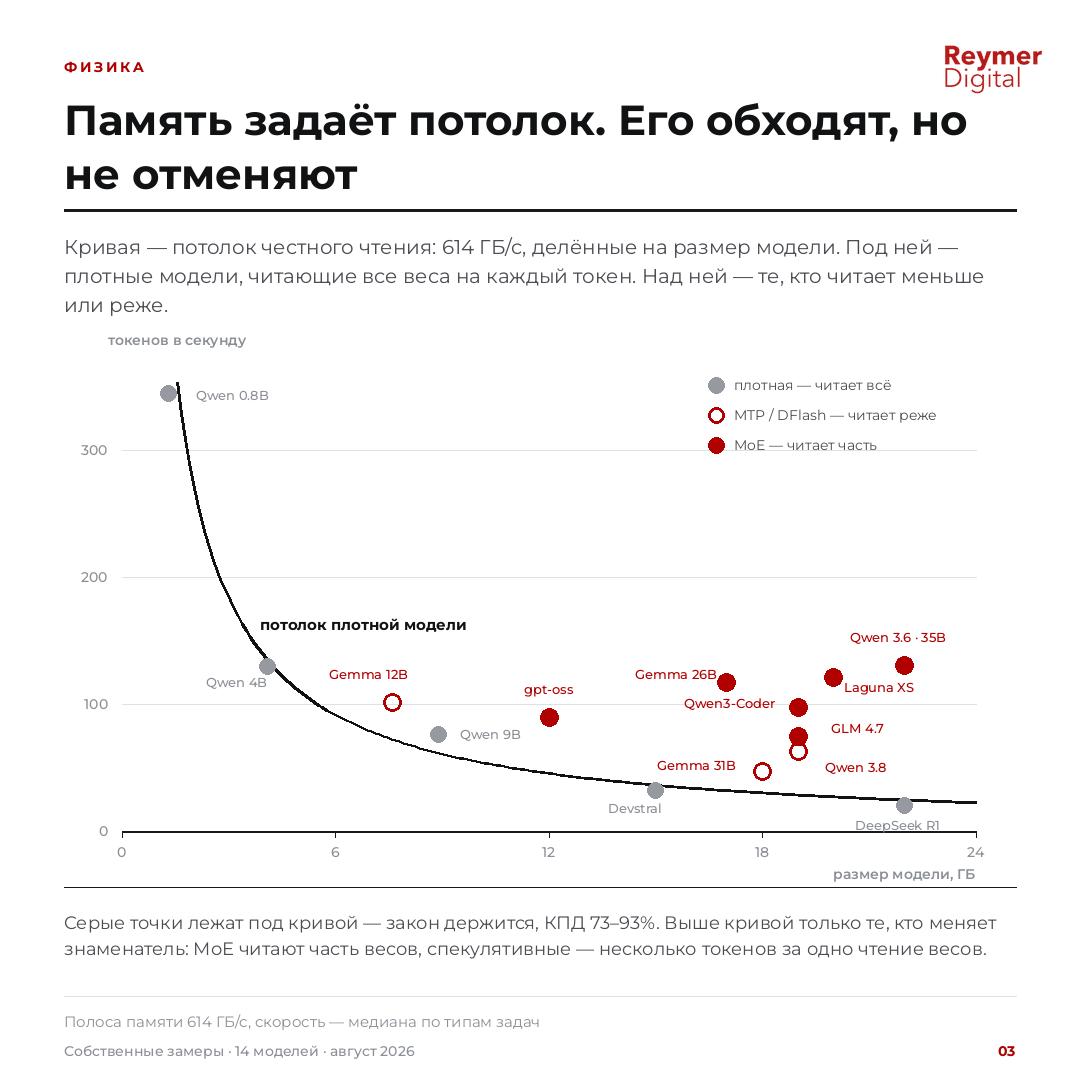
Итого для локальной работы моделей нужно учитывать два параметра:
1) Размер памяти определяет ваш размер модели. 32 Гб достаточно для разработки
2) Скорость ответа определяется скоростью работы памяти.
GLM 4.7 и DeepSeekR1 показали себя крайне слабо - как в скорости, так и в качестве.
А вот кто круче - Gemma4 или Qwen 3.8 - покажут будущие эксперименты.
начинаем локальную сборку